Beam da Reflection: Um Modelo de 501 Bilhões de Parâmetros Treinado com Milhares de GPUs e Algoritmos Inovadores
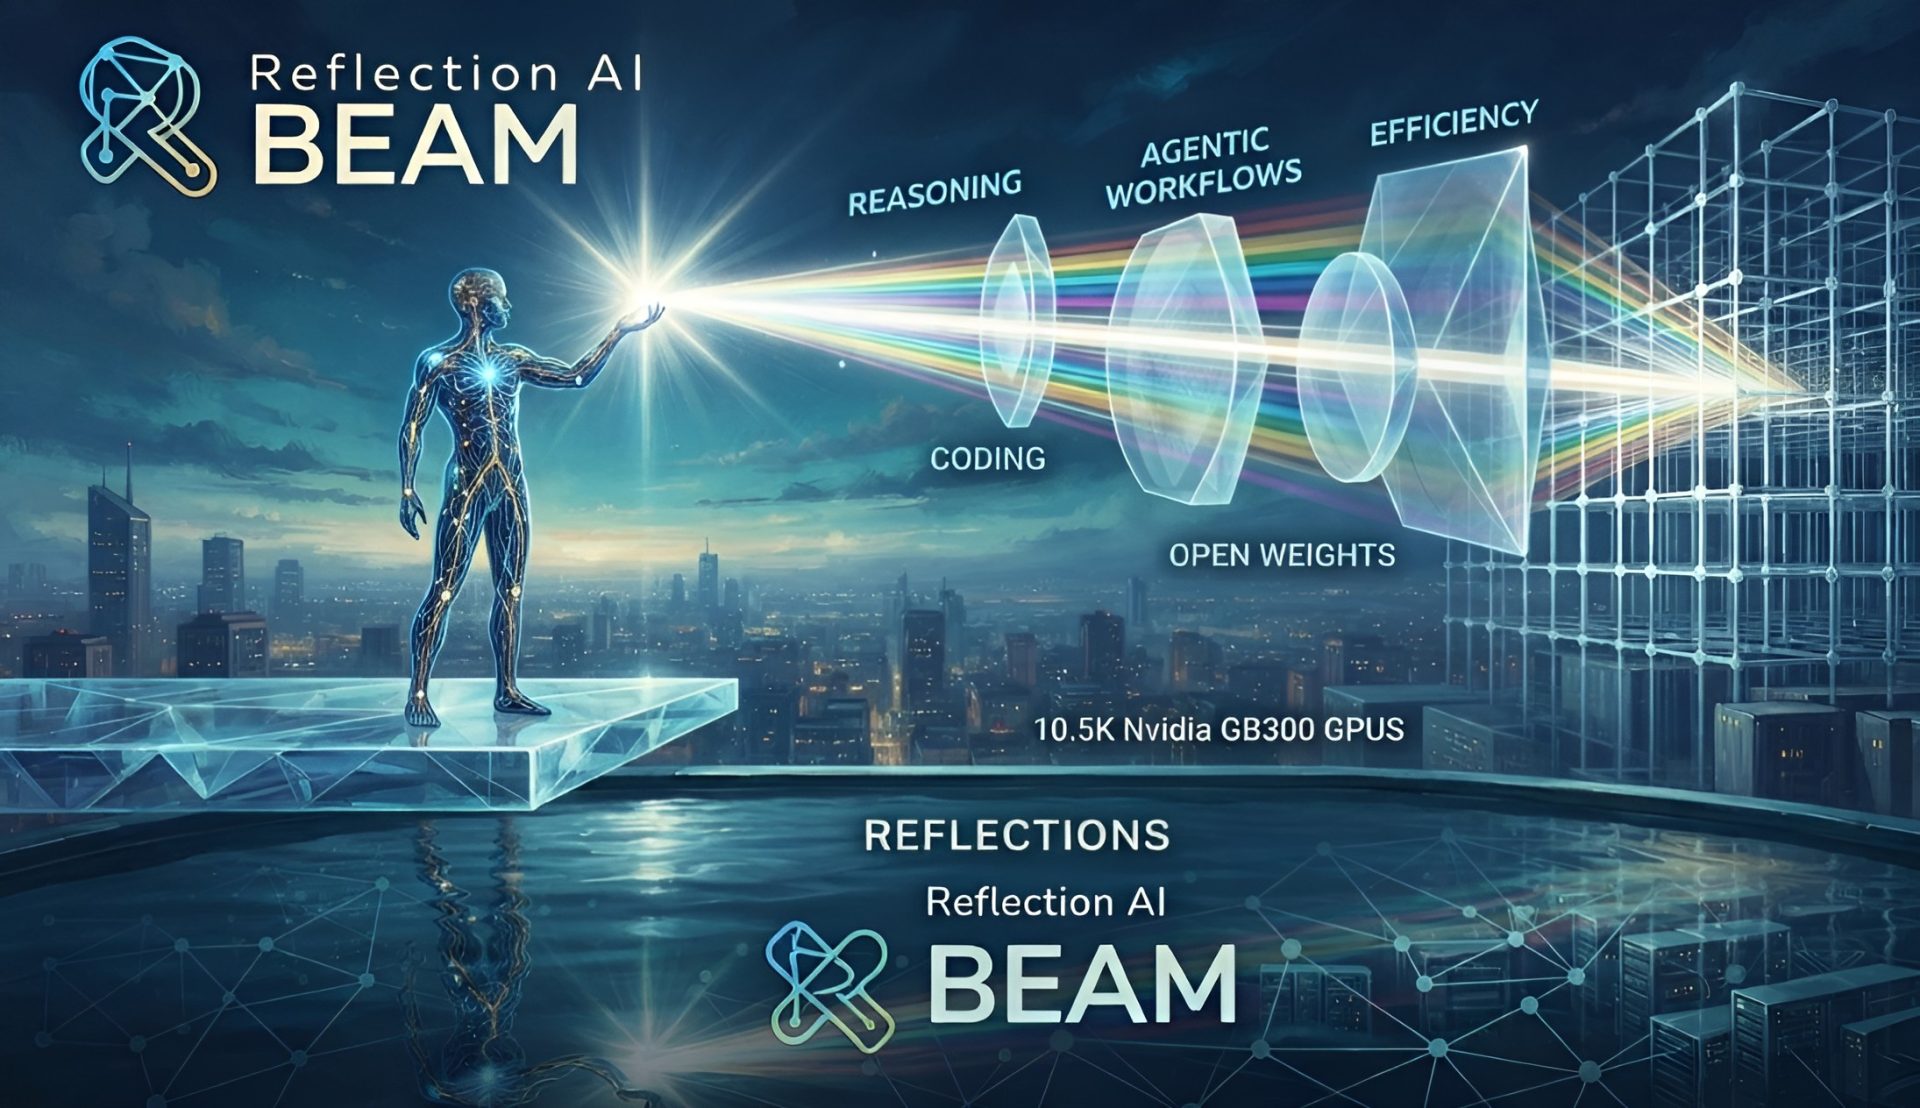
A empresa Reflection anunciou o Beam, um modelo de linguagem de 501 bilhões de parâmetros que se destaca por sua eficiência. O modelo utiliza uma arquitetura de Mixture of Experts (MoE), ativando apenas 23 bilhões de parâmetros em qualquer momento, o que reduz significativamente o consumo de recursos.
Como funciona a eficiência do Beam?
O Beam emprega técnicas como a Uniform Expert Utilization, que distribui igualmente a carga de trabalho entre os especialistas do modelo, evitando sobrecarga em alguns e ociosidade em outros. Além disso, utiliza SandwichNorm, que normaliza os tokens antes e depois de cada camada, garantindo que os valores permaneçam dentro de limites previsíveis. Outra inovação é a Attention Gating, que controla a quantidade de atenção atribuída a partes específicas do texto, aumentando a seletividade do modelo.
Treinamento intenso e escalável
O treinamento do Beam durou quatro semanas, utilizando 1,3 bilhão de sandboxes e 10.500 GPUs NVIDIA GB300. Isso corresponde a 46,4 milhões de sandboxes por dia. A empresa destacou que o modelo foi treinado com uma penalidade de comprimento controlável, incentivando soluções eficientes e reduzindo tokens desnecessários.
Comparação com concorrentes
O Beam supera modelos como o GLM-5.2 em eficiência, necessitando 3 a 4 vezes menos recursos para inferência. Apesar disso, ainda é ultrapassado por modelos como o Qwen 3.8 Max. Para atingir a mesma escala de treinamento, a DeepSeek teria que usar 16 unidades de DSec, totalizando 10.500 GPUs.
Fonte: WCCF Tech